AlphaCode Solutions
당신의 비즈니스를 혁신으로 이끄는 맞춤형 AI 솔루션을 제공합니다.
GPU Manager
분산된 GPU를 하나의 Fleet으로. 퍼블릭·프라이빗 클라우드와 온프레미스에 흩어진 GPU와 NPU를 하나로 묶어, 상태 확인부터 장애 진단, 격리, 복구까지 한곳에서 관리합니다.
인프라는 늘어나는데, 통제력은 흩어지고 있습니다
GPU가 늘어날수록 관리할 곳도 늘어납니다. 기존 모니터링으로는 보이지 않는 문제가 운영 현장에 쌓입니다.
흩어진 자원 정보
클라우드와 온프레미스마다 관리 방식이 달라, 전체 GPU 현황을 한눈에 보기 어렵습니다.
보이지 않는 장애
Kubernetes 노드는 Ready인데 GPU는 이미 비정상인 상태. 이런 '무음 장애'가 워크로드를 멈춰 세웁니다.
흩어진 장애 대응
로그 확인, 격리, 복구를 위해 여러 도구와 시스템을 오가며 처리해야 합니다.
끊어진 운영 이력
경보와 조치 기록이 시스템마다 흩어져, 같은 장애가 반복되어도 알아차리기 어렵습니다.
Ready라고 해서 다 정상은 아닙니다
GPU Manager는 Kubernetes 상태와 별개로 GPU 하나하나의 상태를 판정합니다. 노드가 Ready여도 GPU에 문제가 있으면 바로 드러납니다.
Kubernetes Status
GPU Tech Status
Operation Status
XID·DCGM 오류와 같은 오류의 반복을 기준으로, GPU마다 4단계 위험 등급을 표시합니다.
모니터링을 넘어, GPU 운영 전체를 관리합니다
Unified Visibility
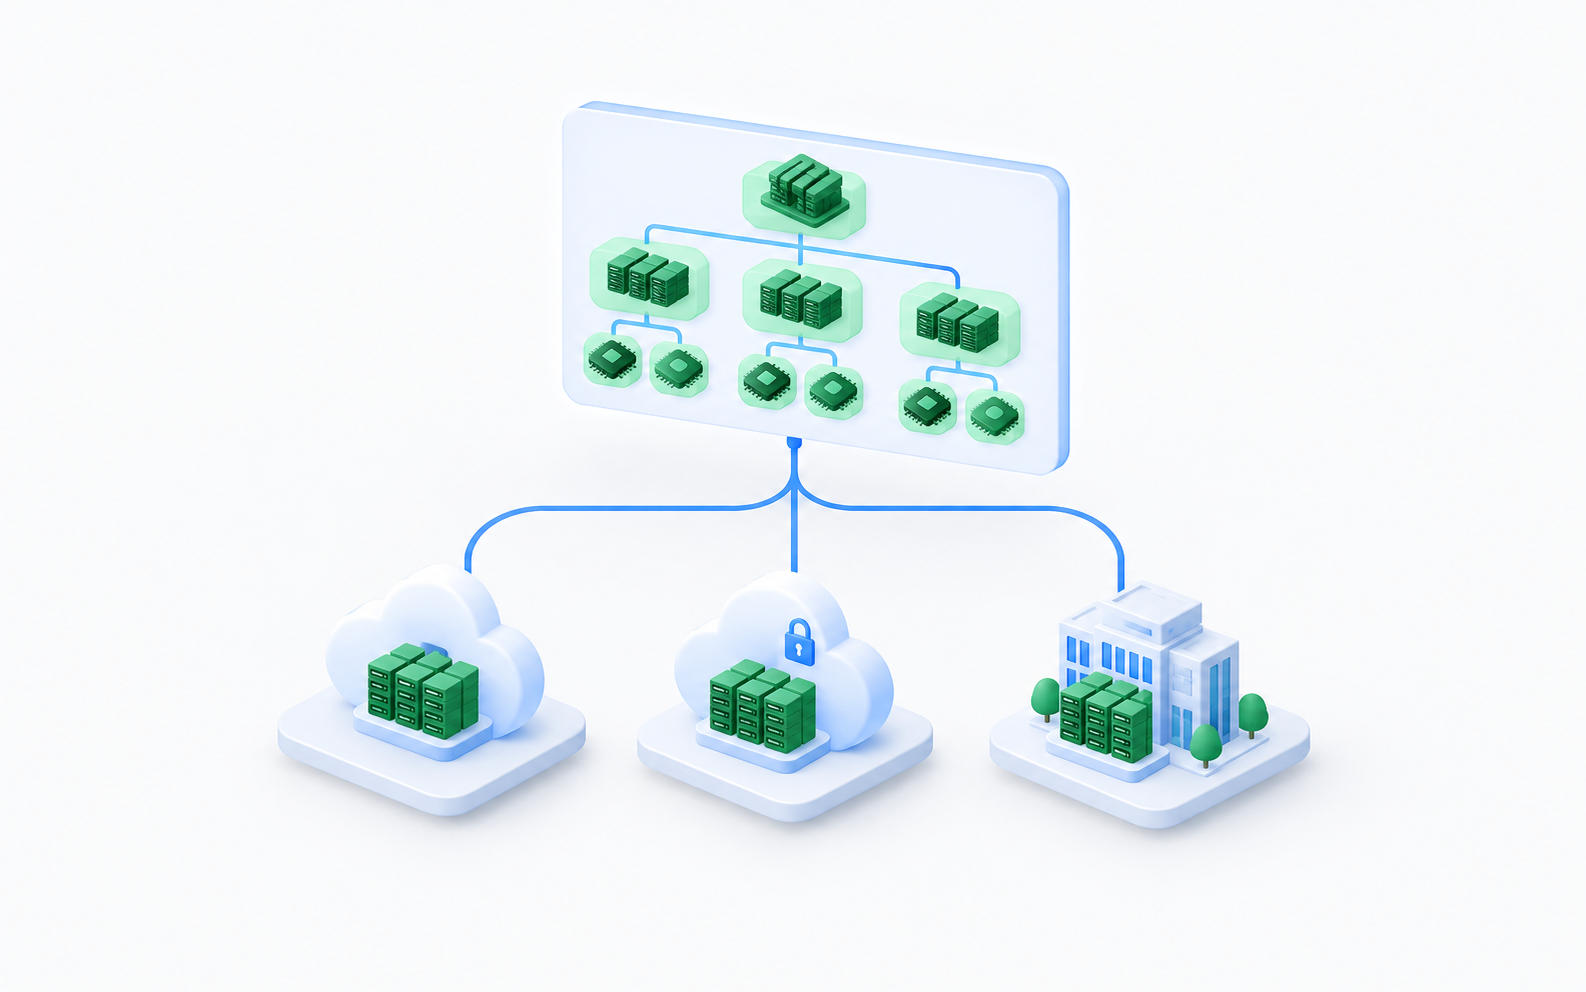
통합 가시성
모든 GPU와 NPU를 한 화면에서
퍼블릭·프라이빗 클라우드와 온프레미스에 있는 GPU와 NPU를 클러스터, 노드, 개별 GPU 단위까지 하나의 구조로 보여줍니다.
Fault Diagnosis
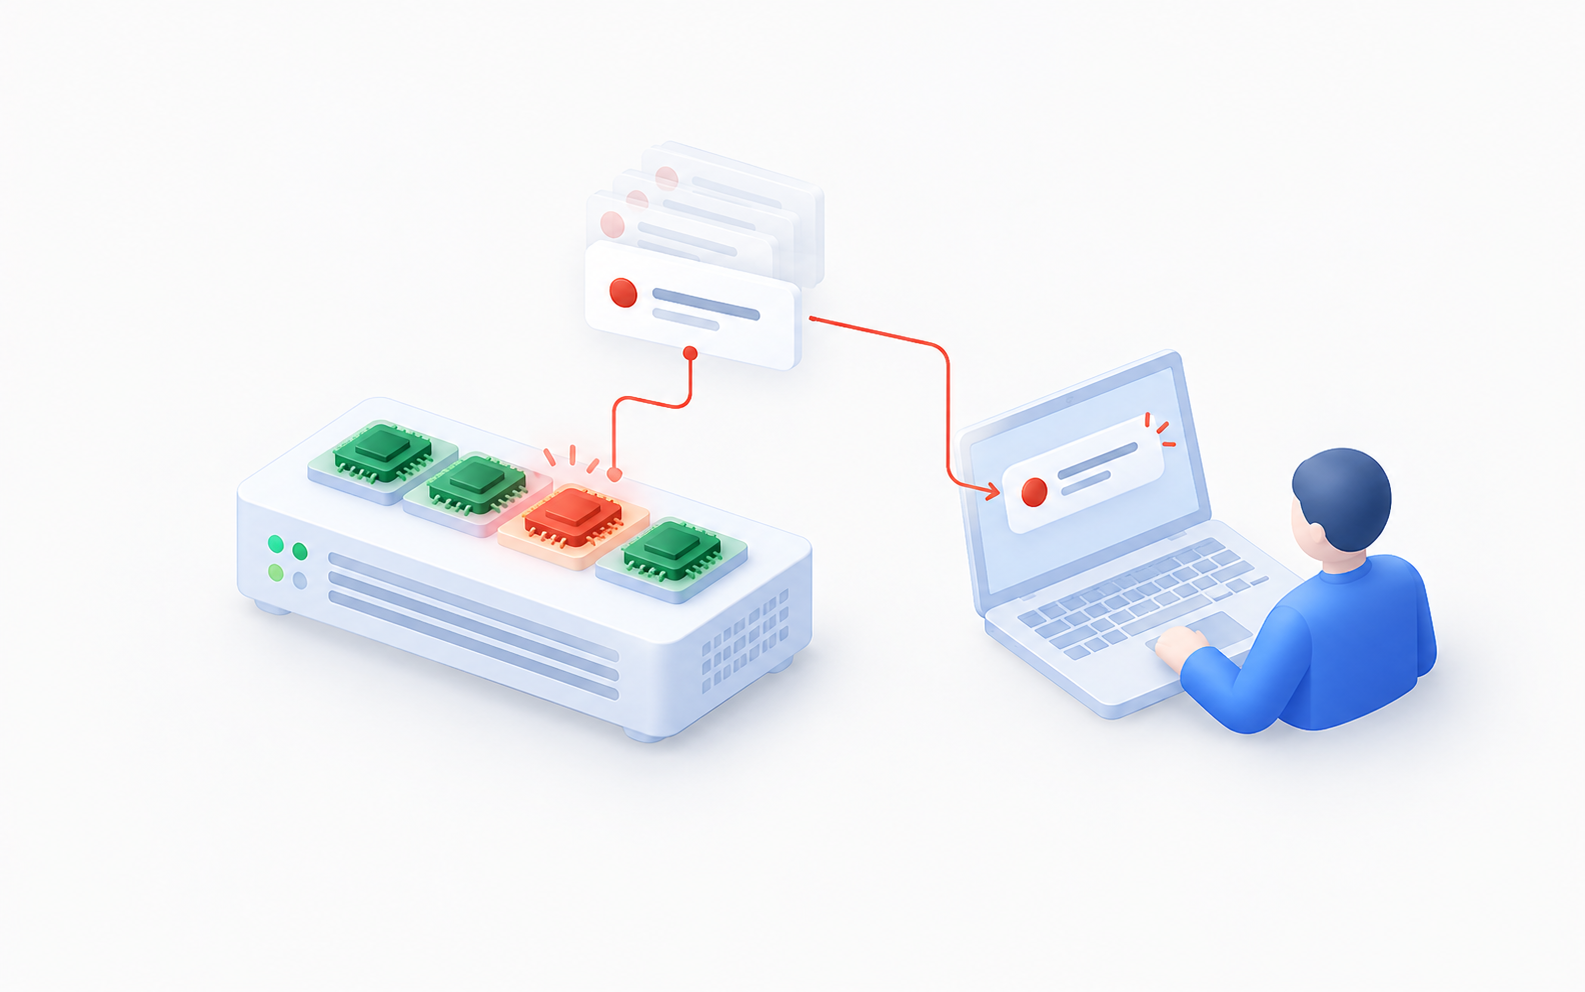
장애 진단과 알림
문제 GPU를 바로 찾아서
XID·DCGM 기준으로 장애를 판정하고, 담당자에게 바로 알립니다. 정기 진단으로 위험 GPU를 확인하고, 같은 장애가 반복되는 GPU도 추적합니다.
Onboarding
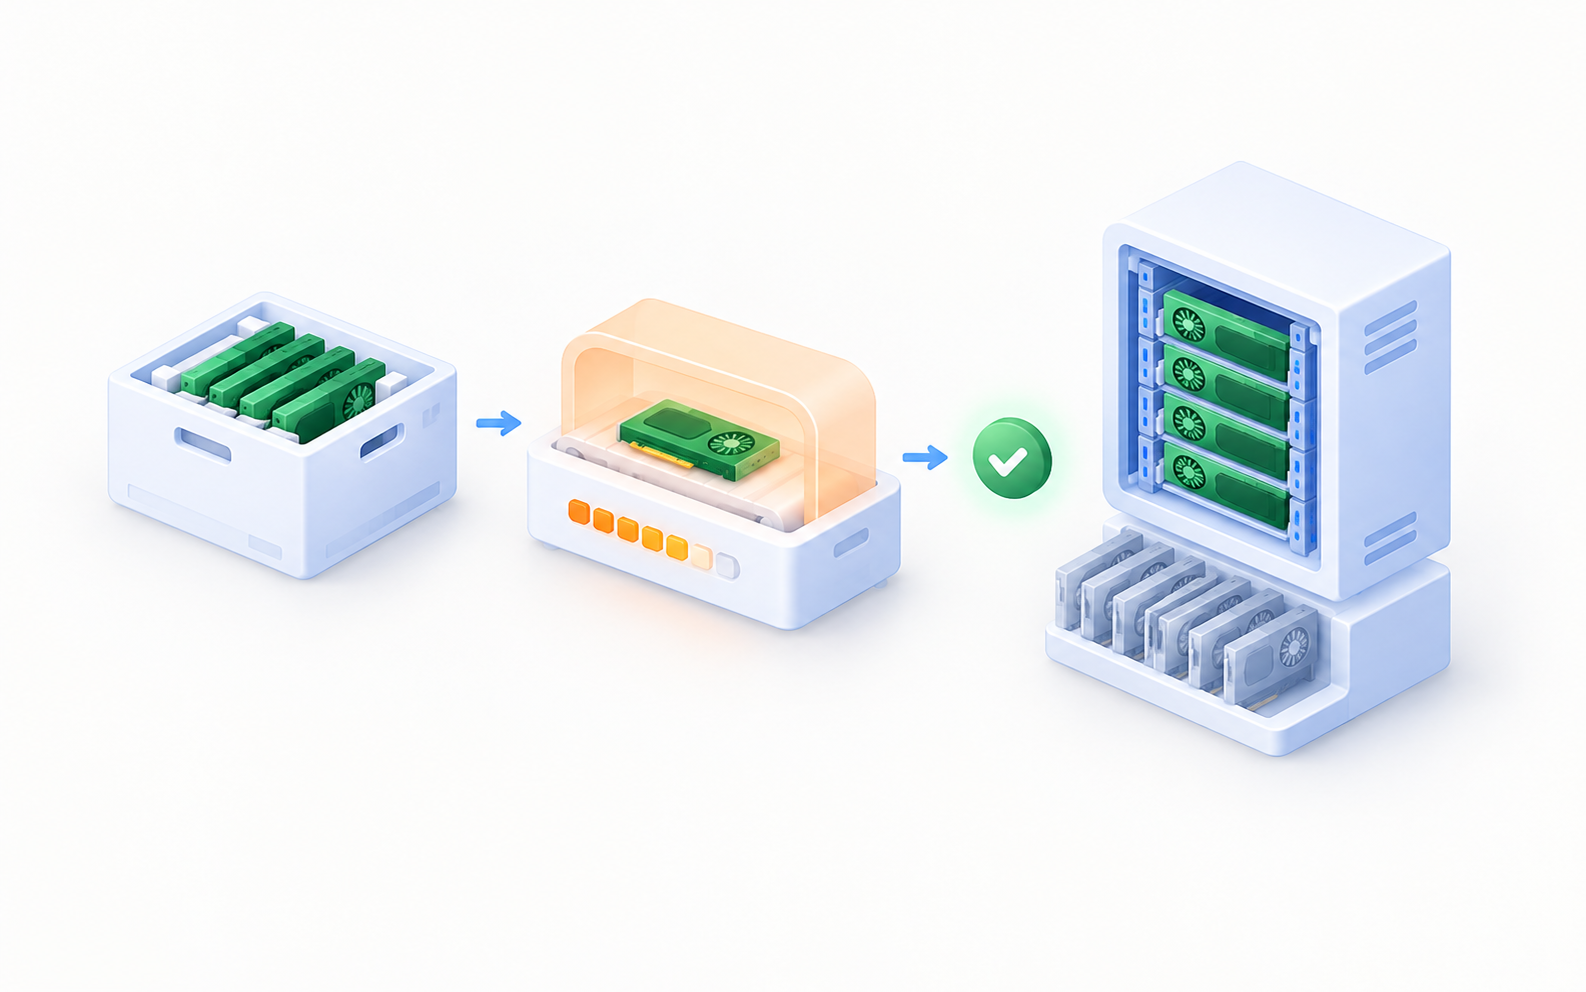
GPU 온보딩 관리
검증된 GPU만 투입
새로 들어온 GPU는 Burn-in 테스트 같은 온보딩 점검을 거쳐 운영에 투입합니다. 보유 GPU와 유휴 GPU도 함께 관리합니다.
탐지부터 복구까지, 끊김 없이
01 · Detect
탐지
Kubernetes가 Ready여도 XID·DCGM 기준으로 GPU 장애를 판정합니다.
02 · Alert
알림
장애 내용을 기록하고 담당자에게 바로 알립니다.
03 · Isolate
격리
문제가 생긴 자원에 새 작업이 배정되지 않도록 막고, 실행 중인 작업을 다른 자원으로 옮깁니다.
04 · Repair
수리
운영자가 장애 유형에 맞는 조치를 진행합니다.
05 · Recover
복구
검증을 통과한 GPU를 다시 운영에 투입합니다.
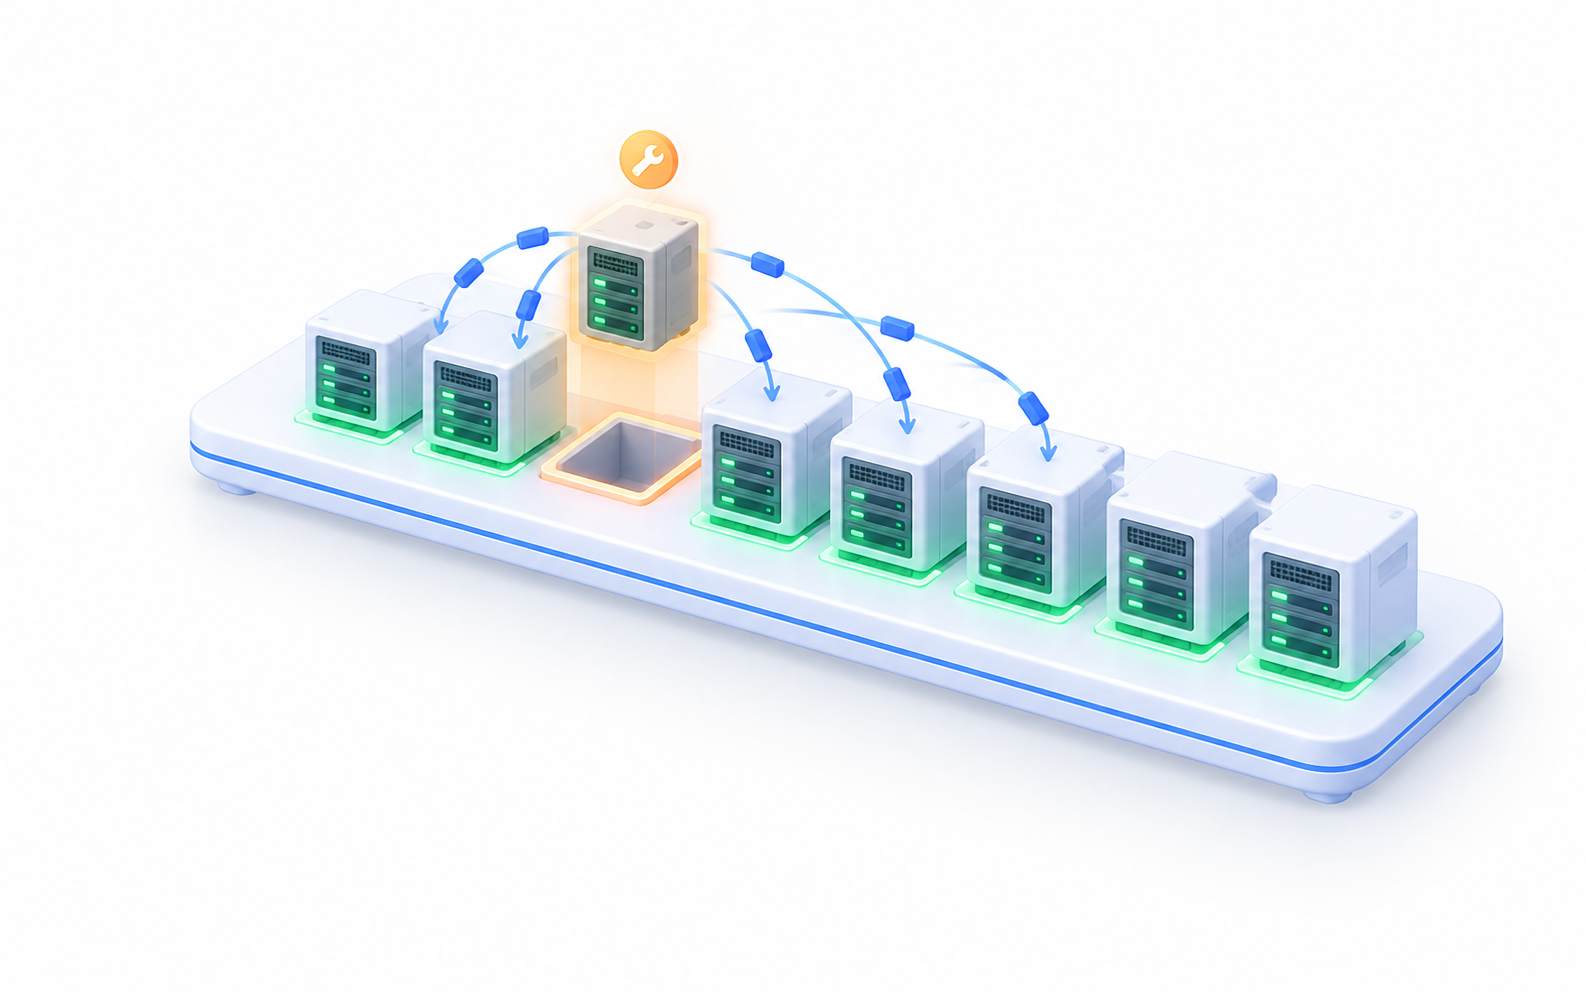
문제가 생긴 곳만 멈춥니다
장애가 난 자원만 운영에서 분리하니, 나머지 자원은 멈추지 않고 계속 일합니다. 환경에 따라 노드 단위 또는 GPU 단위로 격리할 수 있습니다.
누가, 얼마나 쓰고 있는지 한눈에
GPU가 어디에 쓰이고 어디서 놀고 있는지 확인해, 가진 자원을 빈틈없이 활용할 수 있습니다.
Utilization
단위별 사용률
서비스, 프로젝트, 클러스터 단위로 GPU 사용률을 확인합니다.
Inventory
보유 GPU 현황
환경별로 보유한 GPU를 한눈에 파악합니다.
Idle
유휴 GPU
쉬고 있는 GPU를 찾아 다시 활용할 수 있게 합니다.
History
장애 이력과 보고서
장애와 조치 내용을 이력으로 남기고 보고서로 확인합니다.
기존 GPU 모니터링과 무엇이 다른가요
| 항목 | 기존 GPU 모니터링 | GPU Manager |
|---|---|---|
| 관리 범위 | 메트릭과 경보 확인 | 온보딩부터 장애 조치, 복구까지 통합 관리 |
| 관리 단위 | 노드(서버) 중심 | 개별 GPU 중심 |
| 관리 대상 | 환경별로 따로 확인 | GPU·NPU, 클라우드·온프레미스를 한곳에서 |
| 장애 판정 | 단순 임계치 알람 | XID·DCGM 기준 장애 판정과 위험 등급 |
| 장애 처리 | 여러 도구를 오가며 수동 대응 | 탐지, 알림, 격리, 복구를 하나의 흐름으로 |
| 자원 활용 | 사용률을 단편적으로 확인 | 단위별 사용률과 유휴 GPU 파악 |
국내 대형 통신사의 GPU 인프라에서 검증했습니다
여러 클라우드와 온프레미스에 걸친 대규모 GPU 환경에 GPU Manager를 구축했습니다. 알파코드는 설계부터 개발, 장애 진단 기능 구축까지 전 과정을 맡았습니다.
12,000+
하나의 Fleet으로 통합 관리하는 GPU
94.6%
GPU 가용률
4.2시간
다운타임 절감
GPU·NPU
클라우드와 온프레미스를 아우르는 통합 관리
단계적으로 도입할 수 있습니다
Phase 1
가시성 확보
클라우드·온프레미스 연동, 자원 목록 구축, 상태 확인
Phase 2
장애 대응 체계
장애 판정 기준, 알림, 격리·복구 흐름 정립
Phase 3
온보딩 관리
Burn-in 테스트 등 투입 전 점검, 보유·유휴 GPU 관리
Phase 4
운영 최적화
단위별 사용률 분석, 장애 이력과 보고서 활용
모든 GPU를 하나의 Fleet으로
GPU 하나가 멈추면 그 위의 서비스도 함께 멈춥니다. GPU가 늘어날수록 사람의 경험과 여러 도구에 기대는 운영은 한계에 부딪힙니다. 이제 하나의 기준과 하나의 흐름으로 GPU를 운영하세요.
운영 엔지니어
장애가 나도 어디부터 봐야 할지 헤매지 않습니다. 알림을 받은 자리에서 문제 GPU와 지난 이력까지 바로 확인합니다.
서비스 책임자
내 서비스가 쓰는 GPU가 정상인지, 얼마나 쓰고 있는지 운영팀에 묻지 않고 직접 확인합니다.
인프라 관리자
환경별 보유 자원과 유휴 GPU를 근거로, 증설과 재배치를 감이 아닌 데이터로 판단합니다.